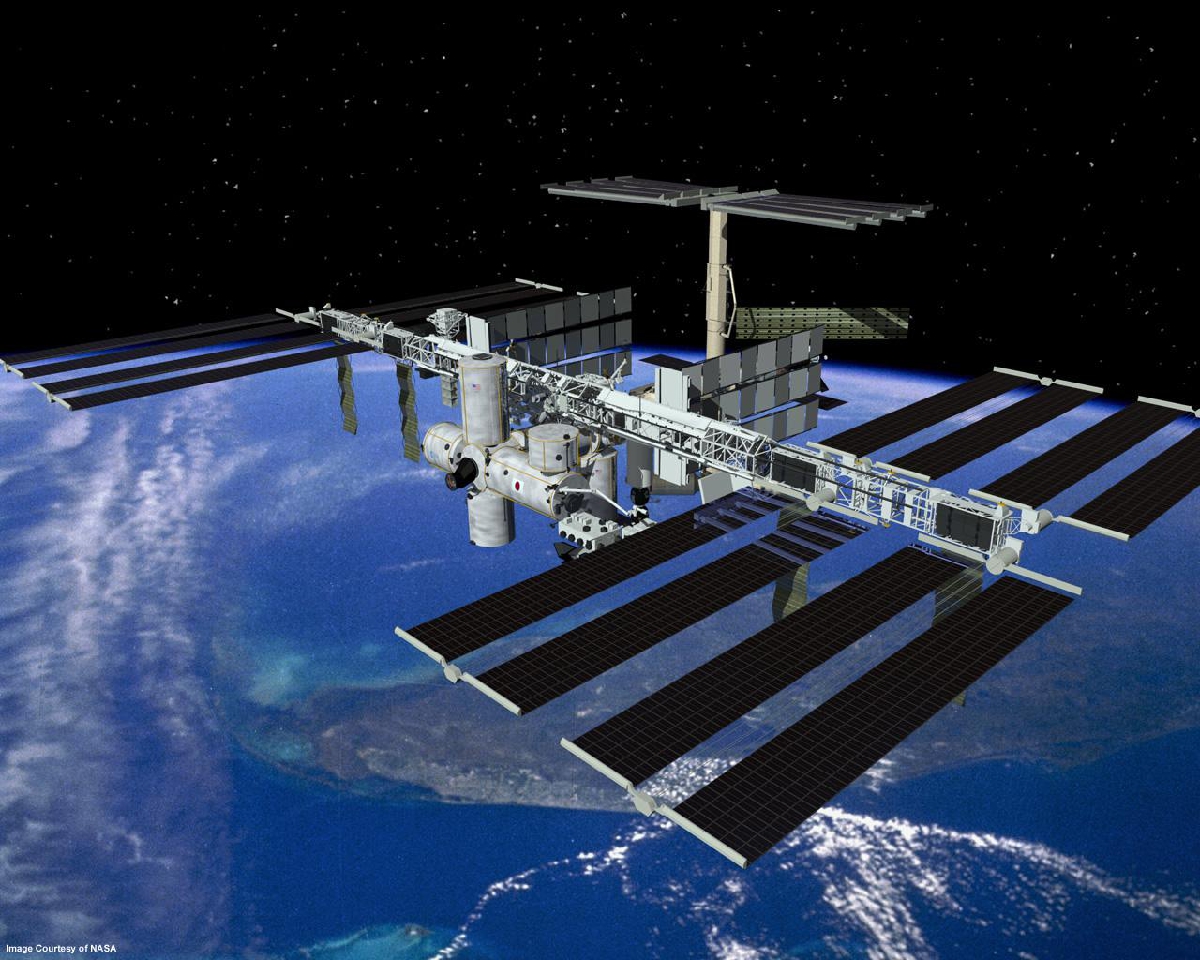
Przez dekady procedury te powierzano sztywnym algorytmom guidance, navigation and control (GNC), rozszerzonym filtrom Kalmana oraz ludzkim pilotom korygującym trajektorię. Opublikowana w repozytorium arXiv praca inżynierów ze Stanford University prezentuje jednak zupełnie nowe podejście – architekturę sztucznej inteligencji zdolną do przeprowadzania „symulacji mentalnych”, która może zrewolucjonizować autonomiczny ruch pojazdów na niskiej orbicie okołoziemskiej.
Dotychczasowe metody telemetryczne i wizyjne napotykają w kosmosie poważne bariery: filtry Kalmana słabo radzą sobie z przetwarzaniem obrazu wideo o wysokiej częstotliwości, z kolei tradycyjne algorytmy widzenia komputerowego są niezwykle podatne na nagłe refleksy światła słonecznego na panelach fotowoltaicznych lub głębokie cienie rzucane przez stację. Próby wdrożenia klasycznego uczenia przez wzmacnianie (RL) – znanego z gier w szachy – ujawniły natomiast ich skrajną nieelastyczność; zmiana reguł, np. przeniesienie portu cumowniczego na inny moduł, prowadzi w takich modelach do całkowitej utraty orientacji.
Zespół ze Stanforda sięgnął więc po koncepcję modelu świata (world model), tworząc system nazwany Out-of-this-World-Model (OWM). Mechanizm ten działa analogicznie do mózgu baseballisty łapiącego piłkę w locie: zamiast rozwiązywać w czasie rzeczywistym cząstkowe równania różniczkowe, sieć buduje intuicyjną symulację fizyki otoczenia na podstawie wcześniejszych doświadczeń, „wyobrażając sobie” dziesiątki potencjalnych scenariuszy przyszłości i szacując prawdopodobieństwo każdego z nich przed wydaniem komendy dla silników manewrowych.
Trening takiego modelu wymagał przeprowadzenia setek tysięcy symulowanych lotów orbitalnych, co na klasycznych procesorach (CPU) zajęłoby całe tygodnie. Aby przełamać to ograniczenie, autorzy opracowali dedykowaną bibliotekę AstroJAX zoptymalizowaną pod kątem procesorów graficznych (GPU). Zastosowanie nowej metody przyniosło spektakularny skok wydajności obliczeniowej: model OWM opanował manewry zbliżania i dokowania w zaledwie 500 000 iteracji, podczas gdy porównywalny system oparty na klasycznym uczeniu przez wzmacnianie potrzebował aż 25 000 000 permutacji. Co istotne, OWM zachował wysoką elastyczność poznawczą – skutecznie reagował na nieznane wcześniej porty dokujące oraz sytuacje awaryjne, na przykład gdy badacze celowo zablokowali docelowy węzeł inną zacumowaną kapsułą.
Mimo wyraźnej przewagi nad klasycznym RL, przed wdrożeniem technologii do rzeczywistych misji pozostaje długa droga optymalizacyjna. Średnia skuteczność dokowania modelu OWM do różnych portów ISS wyniosła w testach 53 procent (wobec 29 procent dla klasycznego RL), przy czym największe trudności sprawiała końcowa faza zbliżenia na minimalne odległości – głównie z powodu zbyt restrykcyjnej kary numerycznej nałożonej w kodzie za ryzyko kolizji, co badacze zamierzają skorygować w kolejnych wersjach.
Choć minie jeszcze sporo czasu, nim autonomiczne modele świata przejmą stery misji załogowych, rosnąca liczba satelitów wymagających serwisowania orbitalnego lub bezpiecznej deorbitacji sprawia, że to właśnie generatywne symulacje staną się fundamentem przyszłej robotyki kosmicznej.
