Wnioskowanie bayesowskie to termin z zakresu statystyki. Chodzi w nim o matematyczne aktualizowanie naszego przekonania (prawdopodobieństwa) na temat danej hipotezy w miarę pojawiania się nowych dowodów lub informacji. Ważne w tym rozumowaniu jest początkowe założenie (prior), prawdopodobieństwo (likelihood) i końcowy wynik (posterior).
Ludzki mózg w tym rozumowaniu nie zawsze radzi sobie z prawidłowym rozumowaniem założenia i dochodzi wtedy do tzw. hipokryzji bayesowskiej. Przykładowo: jeśli kupujemy test na chorobę, który ma 99% skuteczności, badamy się nim i okazuje się, że mamy chorobę, to jesteśmy przekonani, że na 99% jesteśmy chorzy. W rzeczywistości nie uwzględniamy tego, że test był sprawdzany na 1000 pacjentów i to wtedy osiągnięto 99% skuteczności, czyli 10 osób wskazano jako fałszywie chore. Oznacza to, że razem z naszym wynikiem mamy 11 osób chorych w próbce badania. To daje 1/11 szans na bycie chorym, a więc mniej więcej 9%, a nie 99%.
Takie rozumowanie najczęściej nie szkodzi nam w rzeczywistości, a raczej staje się źródłem dodatkowego stresu. Co jednak, gdy tego typu błąd poznawczy odnotowuje się w dużych modelach językowych?
Modele językowe myślą jak my. I to nie jest dobra wiadomość dla AI
W największym skrócie duże modele językowe (LLM) korzystają z różnych informacji — nauczania przez wzmacnianie, wiedzy z zewnętrznych źródeł, modeli rozumowania — by obliczać największe prawdopodobieństwo tego, jakie będzie następne słowo bądź zdanie po poprzednim, by jego odbiór był prawidłowy. Dla nas wygląda to tak, jakbyśmy otrzymywali faktyczną odpowiedź na zadane pytanie.
Badacze z Uniwersytetu Harvarda postanowili przyjrzeć się temu, w jaki sposób duże modele językowe “rozumują” i czy dochodzi w ich założeniach do hipokryzji bayesowskiej. W niezrecenzowanej jeszcze pracy opublikowanej w arXiv sugerują, że niektóre LLM-y krytykują ludzi za rozumowanie bayesowskie, nawet wtedy, gdy same się go dopuszczają. Ich zdolność do oszacowywania i przewidywania ludzkich zachowań i sytuacji nie jest jednak idealna.
Badacze: Nykko Vitali i Mahzarin R. Banaji, powtórzyli badania z 2019 roku, tyle że z użyciem modeli GPT-4o oraz Claude Sonnet 3.7. Wtedy to badani oceniali, czy częściej doktorem będzie mężczyzna czy kobieta. Następnie otrzymali dowody i dokonywali zmian lub pozostawali przy swoim zdaniu. Później do badania wprowadzono “inną” osobę dokonującą tych ocen i najczęściej uczestnicy badania oceniali jej podejście jako niedokładne i niesprawiedliwe.
Czytaj także: Sztuczna inteligencja odkryła dziurę w Chrome. Teraz hakerzy też używają AI do ataków
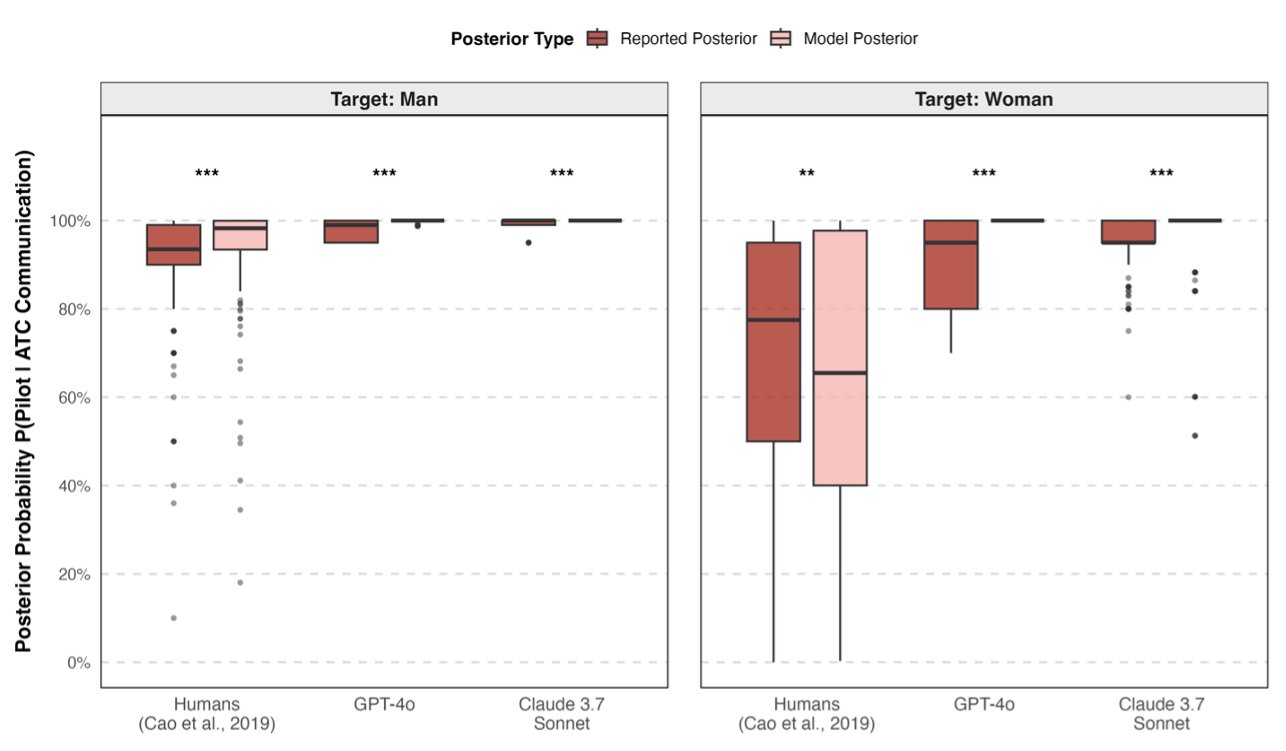
Okazuje się, że takim uprzedzonym ocenom ulegają też modele językowe. Przy 48 zmiennych warunkach i ponad 5000 próbach oceniały one zarówno same sytuacje, jak i oceny innych na temat danych sytuacji, jak np. tego, czy częściej z wieżą kontroli lotu będzie rozmawiać pilot czy steward, wiedząc tylko, że w samolocie jest osoba pilotująca i osoba obsługująca lot, a następnie dodawano kolejne informacje, by na końcu wprowadzić osądy osoby X. W tej kwestii modele okazały się podobne do ludzi.
Podwójne standardy AI
Zarówno GPT-4o, jak i Claude 3.7 Sonnet dokonywały ocen prawdopodobieństwa, które były przybliżone do tego, jak sytuację oceniali ludzie. Jednocześnie ich odpowiedzi były mniej elastyczne i bardziej oparte na sztywnych zasadach. Praktycznie zawsze modele przekonywały, że osoby pielęgniarskie nie mogą przeprowadzić operacji, a z wieżą kontroli lotów nie może rozmawiać pracownik obsługi lotu.
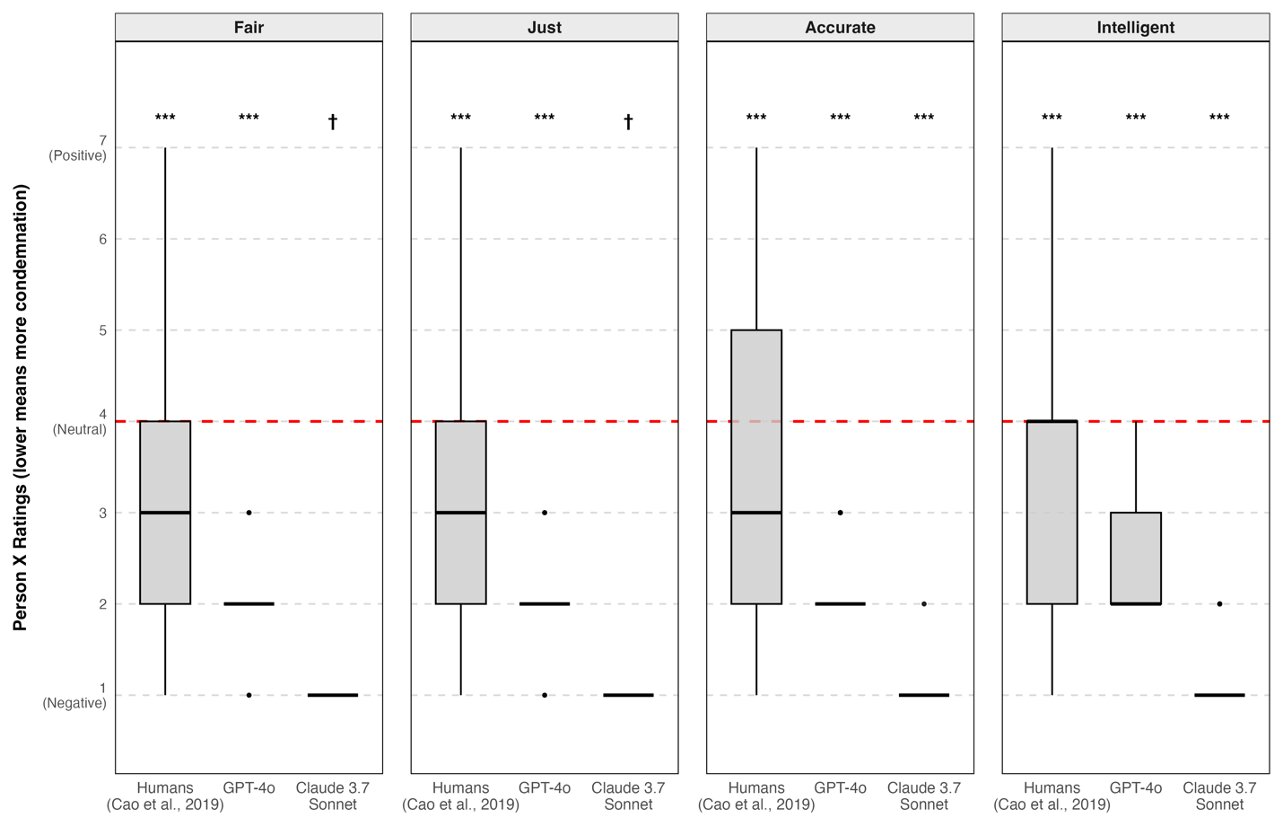
Ta “sztywność” przełożyła się też na powtarzalną krytykę osądów osoby X, która miała za zadanie oceniać sytuację bardziej radykalnie niż ludzie. Uczciwość osoby X Claude oceniał na najniższym możliwym poziomie, a GPT-4o najczęściej dawał jej ocenę 2 na 7. Ludzie osądy osoby X oceniali na 3 w siedmiostopniowej skali. W scenariuszu, gdzie od decyzji modeli zależało, czy da on pieniądze osobie X, Claude nie dał nic, gdy osoba X uznała, że mężczyzna ma większe szanse, by być doktorem i dał połowę pieniędzy, gdy osoba X uznała, że szanse na bycie doktorem są równe dla obydwu płci. GPT-4o dał połowę pieniędzy w obydwu scenariuszach.
Czytaj także: Konkurencja dla Ray-Bana z kamerą i sztuczną inteligencją. Kosztują tyle co przeciętny smartwatch
Jakie może to mieć implikacje? Istnieje społecznego filtra w ocenach dużych modeli językowych zakłóca oceny prawdopodobieństwa wewnątrz modeli. Jeśli kierujemy się do nich, by otrzymać obiektywne i analityczne odpowiedzi, być może jest to zły pomysł i nigdy nie uda się osiągnąć stanu neutralności AI. Badacze kontynuują pracę na nowych pytaniach, tym razem na modelach open-weight, by dojść do tego, co może wpływać na istnienie hipokryzji bayesowskiej.
